

学唱歌为什么像健身:你需要一面镜子和一把尺子
写给每一个在琴房里"凭感觉"练声的人。
教练教一遍,你就会了吗?
我经常把学唱歌比作健身。
去健身房请教练,他教你一个深蹲:脚距多宽、膝盖朝哪、背怎么挺直。教练讲得很清楚,你也听得很明白。那么问题来了——你马上就能做得标准吗?
几乎不可能。
教练转身走了之后,你靠什么把动作练对?反复回看指导的录像,对着镜子检查手的位置、肘的角度,一帧一帧琢磨自己的发力,第二天再来一遍。而且动作标不标准,从来不是"感觉对了"就算数的,它有可以核对的凭据:手到没到这个位置,关节弯没弯到这个角度。这个时候如果有尺子或者量角器,那当然是最好的;没有的话,至少还有一面镜子。
健身的进步,一半靠教练教,另一半靠你在镜子前把教过的东西练对。
唱歌,其实是一种"体内的健身"
声乐训练和这件事一模一样。
Justin 说过一句话:"歌唱是一项逆人体本能的运动。"它调动的是你平时几乎从不单独感知的部位:声带、喉内肌群、呼吸肌群、舌头、软腭,还有喉头的高低。所谓声乐技术,本质上就是对这些肌肉的精确控制。
换句话说,唱歌也有它的"动作标准":这一句,喉头有没有悄悄抬高?舌根有没有后缩?声带闭合够不够?气息给多了还是给少了?深度和压缩的比例,此刻停在什么位置?
这些同样是动作,同样有对错。和健身只差一件事:健身的动作看得见,唱歌的动作看不见。
更麻烦的是,连"听"都未必靠得住。你听到的自己的声音,是颅骨传导和空气传导混在一起的结果,和别人听到的根本不是同一个声音——第一次听自己录音的人,都知道那种陌生感。而 Justin 的教学体系里还有更狠的一句:"你越顺着感觉走,发声越不科学。"
所以问题来了:健身房里有镜子、有尺子、有量角器,声乐的这面镜子在哪里?
老师的耳朵,到底在"听"什么?
肯定有同学要反驳了:我们这些都有老师听,要镜子干什么?
好问题。那老师的耳朵,究竟是怎么听出来的?
人的耳朵是一件非常精密、非常复杂的器官。它不仅能够听出频率和音高,而且特别擅长捕捉泛音列、谐波结构、共振峰的能量分布——只是这些参数在你我的脑子里,原本并没有名字。而"给这些听感命名",恰恰就是声乐教育在做的事:
Justin 老师教学体系的三大平衡——发声平衡、动态平衡、气流均衡——其中的"发声平衡",指声音同时具备足够的深度和金属芯(压缩)。这本来就是一个能用频谱语言描述的状态:深度,写在丰厚的低频泛音里;金属芯,写在 2–4kHz 的高频能量里。深度与压缩的比例,7:3 是重机能,3:7 是轻机能,5:5 是"满血初始原点"。
你看,老师耳朵里听到的东西,是可命名的。但要诚实地说清楚一件事:名字本身,并不能直接拿来测量。
同一个专有名词,在不同的教学体系、不同的老师那里,指的往往是声音里多个要素的不同叠加。比如"共鸣深度",在 Justin 的体系里,它背后是气息支撑、放松的低喉位、打开的咽腔这几件事共同作用的结果;换一位老师,可能会把这个声音叫作"气息支撑"——而他这个词底下叠加的,又是另外几个要素。术语是一种打包方式,各家打各自的包;但包里装的东西——基频、泛音、共振峰的能量分布——是同一批,客观存在于每一次发声里。
所以,SonaLab 不站队任何体系。它不管你学的是哪个门派、信的是哪套术语,只做一件事:把你的声音里本来就能测量到的东西,原原本本地呈现出来。声音本来的样子,与体系无关。
而当你搞清楚了你所在体系的术语,是由哪些要素叠加而成,练习就有的放矢了。甚至,你还可以拿这些客观数据去反推:这个体系、这位老师教给我的概念,是不是一个科学的东西?是不是一个逻辑闭环的东西?数据不会迎合任何门派——它只是在那里。
更何况,还有一件很现实的事:老师不可能随时随刻在你身边。课上你唱的那几十句,他帮你听了;课后你自己练的成百上千句,一个字都没有人听——而动作,恰恰是在课后的几千次重复里定型的。
所以你真正需要的,是一双随时在你身边的耳朵。既然人耳能从泛音列里"听"出这些要素,计算机就能从频谱里把它们"算"出来——而且不下课、不请假:你唱的每一句,它都听得到。
SonaLab:声音的镜子、尺子、量角器
这就是 SonaLab 存在的理由。
它从声音最基本的元素出发——基频、泛音列、共振峰——在你发声的同时完成分析,告诉你声音本来的样子。不是录完再回放,是延迟不到 10 毫秒的实时呈现:你唱,它照。
对应到健身的比喻,健身房里的每一样反馈工具,你的琴房里也有:
还是用健身来类比:这一句的响度有没有达到要求,就是"手到没到这个位置";H1 和 H2 的差值是否达标,就是"关节弯没弯到这个角度"。镜子不会替你做动作,但它让每一次错误都当场现形——而不是在半年后某一次高音挤卡里,才发现自己把动作练错了半年。
一个具体的例子:"深度"要练到什么程度才算够?
老师在课上教会了你一个新动作——"深度共鸣":充分的气息支撑,放松的低喉位,打开的咽腔——正是前面说的,这个术语底下叠加的那几件事。你当场也找到了感觉。可是下课之后,你自己练的时候,怎么知道刚才那一句的深度是够了,还是不够?
SonaLab 内置了 Jeffery 老师录制的示范音频。就拿"共鸣深度"这一组来说:三条音频,同一个元音、同一个音高,只改变一样东西——共鸣深度。先听,再看图——"共鸣深度"这个术语是多个要素的叠加,但落在图表上的读数是单一、即时的;耳朵能听出的差别,就是图中读数的差别。
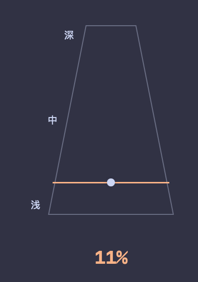
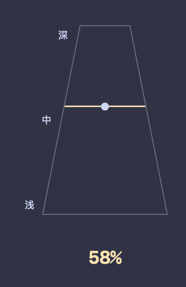
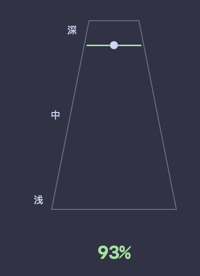
跟着练的时候,共鸣深度图会实时给出你的读数:一个百分比,一个档位。同样一个元音、同一个音高,上面三条的读数分别是 11%、58%、93%——你刚才那一句,落在哪个位置?量角器告诉你,这次关节弯到了 60° 还是 90°——这张图告诉你的,是同一件事。
当然,这三条音频不是"标准答案"。每个人的声音条件不同,深度和压缩的平衡比例本就因人而异。它们是参照物:让你知道刻度盘上不同的位置,听起来、看起来各是什么样子。练习,就是把自己的读数,一步步挪到你想要的位置。
最后,把 Jeffery 老师正式介绍给你:这组示范的录制者,也是 SonaLab 内置示范音频的录制老师之一。要知道,把"浅、中、深"这样细微的差别一条一条唱清楚,本身就是对嗓音控制与听辨能力的双重考验——能唱到这个精度的人,耳朵不会差。想进一步跟他学习的,请移步他的主页:Jeffery 老师的主页
它不取代教练——它让教练的课不被浪费
要说清楚:SonaLab 不是用来取代老师的,就像镜子不取代教练。教练负责把动作教给你,镜子负责让你在没人盯着的那些天里把动作练对——课上学得再明白,功夫都是在课后长出来的。
Justin 老师在大师课里说得很直接——声音诊断是声音训练的核心,而歌手最终要学会的,是自我诊断。没有镜子的重复,不是练习,是复述错误。
他的体系里还有一句我很喜欢的话:技术好的歌手,短暂而规律地练一练,就能恢复平衡,"满血出发"。前提是,他知道自己的平衡丢在了哪里。
这就是那把尺子存在的意义。
最后
声乐的终点是自由表达。但在抵达之前,每一个认真练声的人,都值得先得到一样东西:看见自己声音的能力。
SonaLab 的基础版(L0)永久免费——暖嗓、音高检测、录音回看,macOS 和 iOS 都有。下次练声,不妨给自己一面镜子:sonalab.ai